Índice del artículo
- El arnés explicado con una cocina
- Cinco preguntas que responde un arnés
- Qué ve: el contexto se diseña, no se acumula
- Qué puede tocar: lugar de trabajo y límites
- Cómo sabe que terminó: el bucle de verificación
- Quién mira lo que hizo, y cómo se mide
- Un arnés en la práctica: cómo escribimos contenido en Ciade
- Por qué el mismo modelo rinde distinto
Cuando se habla de agentes de código, casi toda la conversación gira alrededor del modelo: cuál razona mejor, cuál es más rápido, cuál cuesta menos. Pero el modelo solo propone. Lo que convierte esas propuestas en archivos cambiados, pruebas pasadas y errores corregidos es todo lo que lo rodea. A eso se le llama arnés, y a trabajar sobre él, harness engineering.
La documentación de Claude Code lo dice sin rodeos: Claude Code es la capa que rodea al modelo, le da herramientas y gestiona el contexto que ve. Es un arnés. Y buena parte de lo que configuras tú —el archivo de instrucciones, los permisos, los hooks— es tu parte de ese arnés. Aquí tienes la definición corta en qué es un arnés de agentes; esta guía entra en cómo se piensa y cómo se ajusta.
El arnés explicado con una cocina
Imagina un restaurante. El cocinero es el modelo: sabe cocinar, y muy bien. Pero lo que sale a la mesa depende también de la cocina: qué ingredientes tiene a mano, qué recetas están escritas, qué no puede tocar —el horno del pan, la cámara de la carne—, quién prueba el plato antes de que salga y cómo se sabe si el menú de esta semana salió mejor que el de la anterior.
Todo eso es el arnés. Con el mismo cocinero, una cocina ordenada saca platos buenos todos los días; una cocina desordenada saca uno bueno y dos que vuelven a la cocina.
Cinco preguntas que responde un arnés
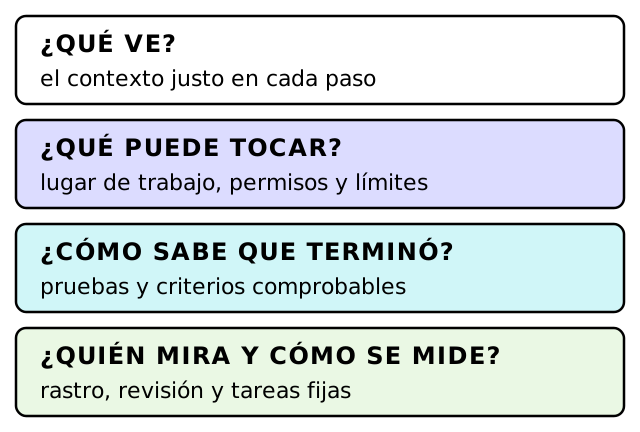
Un arnés se entiende mejor por las preguntas que resuelve que por una lista de piezas. Cada vez que un agente de código da un paso, alguien tiene que haber decidido esto:
- ¿Qué ve? De todo el proyecto, qué entra en la conversación en cada momento: instrucciones, archivos, resultados de comandos, notas de sesiones anteriores.
- ¿Qué puede tocar? Qué herramientas tiene, en qué carpeta trabaja y qué acciones necesitan permiso o están prohibidas.
- ¿Cómo sabe que terminó? Con qué criterio se da por buena una tarea: unas pruebas, un comando que compile, una lista de condiciones.
- ¿Quién mira lo que hizo? Dónde queda registrado cada paso para que una persona o otro agente lo revise.
- ¿Cómo sé si un cambio lo mejora? Con qué tareas fijas se compara antes y después de tocar algo del arnés.
El modelo no responde ninguna de estas preguntas. Las responde el arnés, y quien lo configura.
Qué ve: el contexto se diseña, no se acumula
La ventana de contexto es limitada, y lo que entra compite por la atención del modelo. Un arnés bien pensado le da a cada paso lo que necesita y deja fuera lo demás: el archivo que va a editar y no los otros cuarenta; la línea del error y no el registro entero.
En Claude Code esto se ve en varias decisiones de diseño: las skills solo muestran su descripción hasta que se usan, las herramientas de MCP se cargan normalmente cuando hacen falta y los subagentes trabajan en su propio contexto y devuelven un resumen. Tu parte es mantener corto el archivo de instrucciones y abrir una sesión limpia cuando cambias de tarea.
Qué puede tocar: lugar de trabajo y límites
Un agente que ejecuta comandos puede equivocarse, y el arnés decide cuánto daño puede hacer un error. Hay dos capas:
- Dónde trabaja. Una rama de git separa el historial, pero no los archivos: si el agente trabaja en tu carpeta, los cambios son reales. Para separar de verdad se usa otra copia del repositorio —un worktree—, un contenedor o las sesiones en la nube.
- Qué puede hacer. Los modos de permiso, las reglas de permitir, preguntar y denegar, y el sandbox, que aísla los comandos a nivel del sistema operativo.
Hay un matiz importante: una instrucción escrita («no borres la carpeta de producción») es contexto, y el modelo puede no seguirla. Un bloqueo configurado en el sistema no depende de que el modelo se acuerde. Para lo que importa de verdad, se combinan reglas de denegación, un hook que revise la acción antes de ejecutarla y, cuando hace falta una barrera estricta, el aislamiento del sandbox. Conviene comprobar el alcance real de cada una: una regla sobre un comando puede no cubrir una variante escrita de otra forma.
Así no
Escribir en el CLAUDE.md: «Por favor, no toques la base de datos de clientes».
Así sí
Las credenciales de producción fuera del alcance del agente, más una regla en .claude/settings.json y un hook que detectan los intentos habituales, comprobando qué variantes cubren.
La frase orienta y el agente puede no seguirla en una sesión larga. Lo configurado se aplica aunque la haya olvidado, y sin credenciales no hay forma de llegar.
Cómo sabe que terminó: el bucle de verificación
Sin un criterio de terminado, el agente para cuando le parece que ya está. Con uno, sigue hasta cumplirlo. La documentación de Claude Code lo pone como primer consejo: darle una forma de comprobar su propio trabajo.
En la práctica, eso significa escribir el encargo con condiciones que se puedan comprobar: «las pruebas de este módulo pasan», «la página responde con código 200», «el comando de revisión no da errores». El agente trabaja, comprueba, ve qué falla y vuelve a intentarlo. Ese bucle —hacer, comprobar, corregir— es lo que separa una tarea terminada de una tarea que parece terminada.
Así no
«Añade un cupón de descuento a la tienda».
Así sí
«Añade un campo de cupón en el carrito. Está terminado cuando: el cupón BIENVENIDA se aplica una sola vez por cliente y el descuento se ve en el total; un cupón que no existe muestra "Cupón no válido"; el total del pedido y el del correo de confirmación coinciden; y las pruebas del carrito pasan».
El primer encargo termina cuando al agente le parece. El segundo termina cuando se cumplen cuatro condiciones que tú puedes comprobar.
Quién mira lo que hizo, y cómo se mide
Un arnés que no deja rastro no se puede mejorar. Hace falta ver qué contexto recibió el agente, qué herramienta eligió, con qué datos y qué obtuvo. Claude Code deja la transcripción de cada sesión, y los hooks permiten registrar o revisar acciones concretas.
Y para saber si un cambio en el arnés mejora las cosas, hace falta un conjunto fijo de tareas con el que comparar. Si cambias el archivo de instrucciones y la siguiente tarea sale mejor, puede que solo haya cambiado la tarea. Con las mismas tareas antes y después, la comparación empieza a decir algo.
Un arnés en la práctica: cómo escribimos contenido en Ciade
En Ciade, varias piezas de /aprende las escriben agentes en carriles paralelos, y cada pregunta del arnés tiene una respuesta concreta:
- Qué ve: un documento breve con la voz, las reglas y los moldes, más la ficha de la pieza. Nada del resto del proyecto que no necesite.
- Qué puede tocar: su propia copia del repositorio en una rama aparte. Puede hacer commit, pero no subir nada ni desplegar.
- Cómo sabe que terminó: un validador de contenido que comprueba la estructura y detecta cifras sin fuente y vocabulario que no toca, y que debe pasar sin errores; los enlaces y la veracidad se revisan aparte.
- Quién mira: otro modelo revisa en modo solo lectura y señala lo falso o lo copiado, con la frase exacta. Una sesión principal decide qué se arregla y qué se publica.
- Cómo medimos: el mismo validador y la misma revisión para todas las piezas, así que un cambio en las reglas se nota en los resultados.
Cada vez que algo sale mal, lo normal es que la corrección vaya al arnés —una regla nueva en el validador, una línea más en el documento de reglas— y no a la pieza concreta.
Las piezas del arnés que tocas tú en Claude Code
¿Qué ve?
Qué la resuelve: Archivo de instrucciones, skills, subagentes
Dónde se configura: CLAUDE.md o AGENTS.md, .claude/skills/, .claude/agents/
¿Qué puede tocar?
Qué la resuelve: Modos de permiso, reglas, sandbox, worktrees
Dónde se configura: /permissions, .claude/settings.json, /sandbox
¿Cómo sabe que terminó?
Qué la resuelve: Pruebas y criterios en el encargo
Dónde se configura: El propio encargo y los scripts del proyecto
¿Quién mira lo que hizo?
Qué la resuelve: Transcripciones, hooks, revisiones
Dónde se configura: /hooks, /diff, /code-review
¿Cómo sé si mejoró?
Qué la resuelve: Un conjunto fijo de tareas de prueba
Dónde se configura: Tus scripts de evaluación
Por qué el mismo modelo rinde distinto
Con estas cinco preguntas se entiende por qué dos equipos con el mismo modelo obtienen resultados muy distintos: uno le da el contexto justo, límites claros y una forma de comprobar su trabajo; el otro le da un encargo vago en una carpeta con todo abierto. El modelo es el mismo; el arnés, no.
Si quieres ver todas las piezas de Claude Code con detalle, sigue con la guía completa de Claude Code.
Términos relacionados
Formación
Aprende a usar la IA en tu trabajo, con criterio.
El nivel 0 es gratis: cuarenta minutos para entender qué pedirle a la IA y qué revisar. El programa completo enseña a implementarla en tu propio negocio, tarea a tarea.